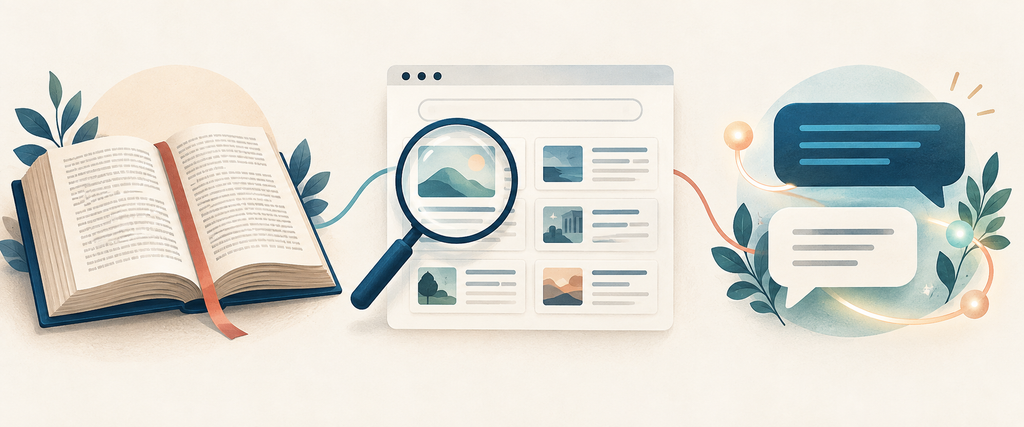
Sprachmodelle sind eingebettet in ein Medium, das abhängig ist von Web 2.0 Internettechnologien. Benutzerinnen (m/w) sind vertraut mit schriftlicher / audio-visueller Echtzeitkommunikation zwischen Sender und Empfänger. Bei ChatGPT und ähnlichen Plattformen zahlt man dafür (mit Daten oder Geld), dass der zweite Gesprächsteilnehmer ein Sprachmodell ist, das (fast) alle Artefakte der Menschheit in einer hilfreichen Weise abrufen und in einen Zusammenhang mit meiner Frage stellen kann. Das seltsame Problem der Herrschaft der Sprache, von dem im letzten Beitrag die Rede war, wird in diesem Zusammenhang versuchsweise präzisiert.
Was ist ein Gespräch?
- Angenommen, ein Gespräch besteht aus Gesprächsteilnehmern (m/w/b), die Nachrichten austauschen.
- Man kann dann zwischen dem Resultat eines Gesprächs und der Aufzeichnung des Gesprächs unterscheiden. Die Aufzeichnung des Gesprächs ist objektiv verfügbar, das Resultat kann für jeden Gesprächsteilnehmer unterschiedlich sein.
- Das Resultat eines Gesprächs ist die Veränderung der Situation. Ich beginne ein Gespräch aus einer Motivation heraus, d.h. einem Bedürfnis, welches am Ende des Gesprächs befriedigt, enttäuscht, oder neu arrangiert wird.
- Das (b) in Punkt 1 stand für Bot: Ein Sprachmodell in einer Chatbot-Plattform ist ein Gesprächsteilnehmer. Die Plattform stellt diesen Teilnehmer für ihre Benutzer (m/w) zur Verfügung. In aktuellen ChatGPT-ähnlichen Plattformen gibt es üblicherweise einen menschlichen Teilnehmer (den Benutzer), und einen Teilnehmer, das Sprachmodell. Der Einfachheit halber werden stille Teilnehmer (die asynchron oder synchron eingebunden sind) im Folgenden nicht primär besprochen.
- Jeder Benutzer der Plattform findet für sich ein Resultat des Gesprächs, und hat außerdem eine Aufzeichnung des Gesprächs zur Verfügung. Das Sprachmodell erhält iterativ Zugriff auf die Aufzeichnung des Gesprächs und generiert Token-für-Token weitere Zeichenketten nach bestimmten Kriterien und auf Basis der im Modell komprimiert gespeicherten Informationen.
- Das Hauptkriterium für das Sprachmodell ist gegenwärtig Nützlichkeit. Dies liegt daran, dass Benutzer Chatbot-Plattformen vor allem dann verwenden, wenn sie damit ein Bedürfnis befriedigen können. Es ist jedoch technisch möglich und in manchen Kontexten sinnvoll, die Optimierung von Nützlichkeit auf andere Kriterien zu orientieren: z.B. den Erwerb von Fähigkeiten der Benutzer in Bildungskontexten, oder das Befolgen von Gesetzen, auch wenn sie das Bedürfnis der Benutzer enttäuscht, usw.
- Man kann die informationstechnologische Entwicklung so sehen, dass sie zunehmend in Richtung individuelle Nützlichkeit optimiert wird. Das kann wie folgt an drei Kulturtechniken skizziert werden:
Buch: Wissen steht als statische Informationsquelle zur Verfügung. Eine konkrete Fragestellung des Individuums kann nicht unmittelbar beantwortet werden. Man tritt auch nicht in ein Gespräch mit dem Autor des Buches, außer metaphorisch. Die Antwort findet sich beim Lesen und Durchforsten des Buches.
Wiki / Suchmaschine: Die räumliche Beschränkung von Büchern wird effektiv durch Wikis aufgehoben. Zeitlicher Aufwand wird durch Suchen minimiert. Wikis können konzeptionell unendlich lang sein (Bücher sind Geduldig, aber Datenbanken um ein Vielfaches mehr). Diese Qualität macht die Suche mit Suchbegriffen zu einer essenziellen Kulturtechnik. Die Suchmaschine generalisiert die Suche in einem konkreten Dokument auf den gesamten im Internet öffentlich verfügbaren Dokumentkorpus. Das ermöglicht Benutzern zwar konkrete Fragen zu stellen, die Antworten stehen aber in vielen Fällen in einer Distanz zur Frage. - Sowohl Bücher als auch Suchmaschinen benötigen daher die Fähigkeit der Selbstreflexion. Man kann beim Lesen eines Buches und zu einem gewissen Grad beim Durchforsten von Suchergebnissen vom existierenden Material und seinen Überlegungen dazu bewogen werden, die Fragestellung zu ändern: Das Buch stellt meine Fragestellung in Frage, sie ändert “in mir” etwas (Anführungszeichen sind hier angebracht). Die nur teilweise relevanten Suchergebnisse machen es notwendig, mich anders auszudrücken – oder zu realisieren, zu welchem Teil meine Fragestellung speziell ist und im etablierten Wissenskorpus nicht explizit vorhanden ist, oder zu realisieren, dass meine Frage keinen Sinn macht. Die Suchmaschine stellt im Vergleich zum Buch jedoch einen ersten Schritt zur Optimierung auf individuelle Fragestellungen vor, man könnte sagen, dass der Bias des Buches die Wissenspraktiken in Richtung Konsumieren von etablierten, aufgeschriebenen Wissens optimierte (Autoritäten), während die Suchmaschine bereits die Vorstellung verstärkt, dass mir zu meiner Fragestellung konkretes Material zur Verfügung gestellt wird, um mein Bedürfnis zu befriedigen und ich mir die Antwort dann selbst zusammenstellen kann (Remix-Kultur). Die Neugier für ein allgemeines Thema, das ein Buch behandelt, wird fokusiert auf Hilfreiches für meine spezielle Fragestellung. Es scheint, dass der Benutzer des Tools dadurch an Macht gewinnt, andererseits verlässt man sich zunehmend darauf, dass das Medium konkrete Antworten liefert. Beim Buch muss man selbst relevante Stellen finden; die Suchmaschine findet für einen relevante Stellen. Die Suchmachine folgt jedoch Algorithmen, die im Rahmen von privatwirtschaftlichen Interessen entwickelt und verfeinert werden. Es soll nützlich wirken, damit Benutzer weiterhin interagieren, doch tatsächlich wird das Bedürfnis nach Wissen gekapert und durch Interessen von Unternehmen, die eigene Inhalte positionieren, überlagert.
- Chatbot-Plattformen ermöglichen einen signifikanten Qualitätssprung, was die automatische Erstellung von Antworten auf Benutzerfragen betrifft. Dadurch wird dem Medium jedoch noch mehr Macht zugesprochen. Ich stelle eine Frage und bekomme eine glaubwürdige Antwort. Die Glaubwürdigkeit kommt dadurch zustande, dass Sprachmodelle auf menschliche Nützlichkeit hin optimiert wurden. Die Konstruktion der Antwort erfolgt Token für Token so, dass Benutzerinnen höchstwahrscheinlich die Antwort für plausibel halten. Was dadurch mit Hilfe von stochastischen Methoden kaschiert wird ist der Unterschied zwischen der spezifischen Fragestellung und vergangenen Dokumenten.
- Was uns als Homo sapiens auszeichnete, zum Beispiel die Fähigkeit, eigene Problemstellungen auf Basis von etabliertem Wissen und eigener Vorstellungskraft zu lösen, wird nun durch Sprachmodelle herausgefordert. Es scheint, als ob das Modell uns versteht, und darum direkte Lösungen liefern kann. Mit zunehmender Verwendung und Verfeinerung der Plattformen wird die Qualität der Antworten verbessert und der Anschein von Verständnis verstärkt. Wir fühlen uns verstanden. Dafür brauchen wir keine Anführungszeichen.
- Kommunikationstheoretisch sind Gespräche in der Chat-Plattform komplementär, so wie ein Arzt-Patienten-Gespräch: Ich habe diese Beschwerden und suche Erleichterung. Suchmaschinen konnten in vielen Fällen nur Ansätze zur Verfügung stellen bzw. auf Dokumente von anderen Personen hinweisen, in denen gesuchte Worten vorkommen. Sprachmodelle hingegen induzieren die Vorstellung, dass eine passende Antwort zu meiner Frage automatisch generiert wird, unabhängig von menschlichen Produktionen. Technisch gesehen ist die Einbindung von menschlichen Produktionen einerseits vorgelagert auf die Phase des Trainings und Optimierens des Sprachmodells, andererseits abhängig von der Frage selbst: Über Stochastik, nicht über logische Schlussfolgerungen oder Beherrschung von Wissensdomänen, werden etabliertes Wissen und individuelle Frage in Einklang gebracht. So erhielt ich eine konkrete Antwort auf meine Frage, wie ich die Version dieses Blogs mit Hilfe eines Command Line Interfaces im Terminal des Servers aktualisiere.
- Dieser Beitrag spricht nicht oder nur indirekt von zwischenmenschlichen Gesprächen. Es gibt in diesem Fall zwei Gesprächsresultate: Das Resultat für Teilnehmer 1 und das Resultat für Teilnehmer 2. Gemeinsame Sprache verändert sich durch diese Divergenz. Man versteht etwas anderes, weil man eine andere Position einnimmt, weil man andere Voraussetzungen/Motivationen/Bedürfnisse hat. Ein Sprachmodell hat auf diese Diversität keinen Zugriff, so wie Teilnehmer 1 nicht auf Teilnehmer 2. Möchte man sagen. Was aber lässt mich wissen, dass das Sprachmodell keinen Zugriff hat auf vor-sprachliche Motivationen, dieses messy Territorium, das aber mit Sprache zusammenhängt? Wie unterscheide ich zwischen einem menschlichen Teilnehmer 2 und einem Sprachmodell-Teilnehmer 2?
- Ein Versuch: Sprachmodelle kalkulieren das nächste Wort, auf Basis von Input und Gewichten. Sie sind in der Sprache mehr zu Hause als menschliche Teilnehmer. Menschen versuchen sich auszudrücken, wenn sie sprechen und schreiben. Und weil es sich um eine gemeinsame Sprache handelt, sind sie mit dem Gesagten nie ganz zufrieden. Die Wörter sind inadäquat im Vergleich zu dem, was sie sagen wollen. Die Inkonsistenz der Sprache wird von Sprachmodellen konsistent gemacht, und diese Tatsache durch Wahrscheinlichkeiten kaschiert. Ist es möglich, das an Beispielen aufzuzeigen? Vielleicht ein anderes Mal.
Ein paar Punkte zu diesem Beitrag.
(1) Die Erweiterung des Gesprächsbegriffs von der Interaktivität zu ihrer Vor- und Nachgeschichte ist ein entscheidender Schritt. Wir reden zunächst von Sprechakten, aber dann auch von Gesprächsprotokollen und Gesprächsergebnissen. Es ist eine Nachlässigkeit, die Möglichkeit der Aufzeichnung und der Umsetzung nicht mit hineinzunehmen. Ein besonderer Effekt in der (m/w/b) Situation ist dann, dass sowohl “Aufzeichnung”, als auch “Resultat” ohne Kopfzerbrechen auch auf b_s angewandt werden kann: digitale Kodierung, programmierte Triggerfunktion. Ein Mausklick produziert der Start eines Videos, eine Fragestellung eine Rückmeldung.
(2) Ebenso wichtig ist der Hinweis, dass KI-Agenten in ihrem derzeitigen populären Auftreten darauf trainiert sind, den Benutzerinnen (bis zur Unterwürfigkeit) entgegenzukommen. Das muss nicht sein. Man kann sich vorstellen, dass ein zunächst dienstbereiter Bot zu einem Lügenbot gehackt wird. Selbstgesteuerte Drohnen in einer (b, b) Situation qualifizieren sich nicht für ein Gespräch. Das führt zum dritten Punkt.
(3) Die Spanne zwischen der zwingend situierten Ausgangsfrage und dem jeweils global bereitgestellten Sprachreservoir suggeriert eine unüberbrückbare Kluft zwischen den “allwissenden” KI-Agenten und den bescheidenen Einzelfragen, auf die die gesamte Firmenmacht der globalen Digitalisierung losgelassen wird. Man muss aber sehen, dass unter dem Aspekt der Nützlichkeit die Rollen gleich verteilt sind. Wer mit den Rückmeldungen nichts anfangen kann, wird von den Mega-Kapazitäten nicht beeindruckt sein. Allerdings schützt ihn das nicht davor, zum Opfer ungebetener Interaktionen zu werden.
(4) Die KI-Agenten “sind in der Sprache mehr zu Hause als menschliche Teilnehmer”. Das kann man verschärfen: Sie sind zunächst *nur* in der Sprache zu Hause. Alles was sie *sind* besteht aus elektronischen Schaltungen, deren Regeln vom Menschen “abgeschaut” wurden. Ketzerisch ausgedrückt: “Und das Wort ist Programm geworden und hat unter uns gewohnt” (vgl. Johannesevangelium 1, 14) Hinzuzufügen ist: mit der Anrede “Wort” ist schon die komplette Geschichte menschlicher Zivilisationen in den Satz eingeschleust.